터미널 사용 예시
실제 kpubdata 출력 화면이다. 모든 예시는 실제 실행 결과를 캡처했다.
Python — 데이터 조회
>>> from kpubdata import Client
>>> client = Client()
>>> ds = client.dataset("datago.air_quality")
>>> batch = ds.list(sido="서울", page_size=3)
>>>
>>> print(ds.id, ds.name)
datago.air_quality 대기오염정보 조회서비스 (Air Quality)
>>>
>>> for item in batch.items[:2]:
...     print(f"{item['stationName']:8s}  KHAI={item['khaiValue']}  PM10={item['pm10Value']}")
강남구      KHAI=43  PM10=25
서초구      KHAI=58  PM10=27
>>>
>>> print(f"총 {batch.total_count}개 측정소, 다음 페이지: {batch.next_page}")
총 40개 측정소, 다음 페이지: 2
Python — 오류 처리
>>> from kpubdata import Client
>>> from kpubdata.exceptions import DatasetNotFoundError, AuthError
>>>
>>> client = Client()
>>> try:
...     client.dataset("datago.nonexistent").list()
... except DatasetNotFoundError as e:
...     print(f"{type(e).__name__}: {e}")
DatasetNotFoundError: Dataset not found: datago.nonexistent
CLI — 데이터셋 탐색
$ # 전체 데이터셋 목록 (Provider별)
$ kpubdata datasets list
id                                        name                                      provider   operations
----------------------------------------  ----------------------------------------  ---------  -----------------
bok.base_rate                             한국은행 기준금리 (BOK Base Rate)                 bok        list, raw
datago.air_quality                        대기오염정보 조회서비스 (Air Quality)              datago     list, raw
datago.apt_trade                          아파트매매 실거래가                            datago     list, raw
...                                       ...                                       ...        ...

$ # 특정 데이터셋 상세 정보
$ kpubdata datasets show datago.air_quality
field              value
------------------  ----------------------------------------
id                 datago.air_quality
name               대기오염정보 조회서비스 (Air Quality)
provider           datago
operations         list, raw
CLI — 데이터 조회
$ # 대기오염 데이터 조회 (JSON 출력)
$ kpubdata fetch datago.air_quality --param sidoName=서울 --page-size 3 --format json

$ # CSV 형식으로 저장
$ kpubdata fetch datago.air_quality --param sidoName=서울 --format csv --output air.csv
검증 파이프라인 — make verify
$ # 데이터셋 4단계 검증 (스키마 → fixture → replay → 예제 실행)
$ make verify
[통과] datago.air_quality
[통과] datago.apt_trade
[통과] datago.hospital_info
[통과] datago.tour_kor_area
...
[통과] localdata.general_restaurant
[통과] localdata.rest_cafe
검증 결과: 22개 데이터셋, 전체 통과
검증 파이프라인 — make record
$ # 실API 호출로 fixture 기록 (raw/meta/expected 3종 생성)
$ make record DATASET=datago.air_quality
기록: tests/fixtures/datago/air_quality/seoul.raw.json (3건, total=40)
기록: tests/fixtures/datago/air_quality/seoul.meta.json
기록: tests/fixtures/datago/air_quality/seoul.expected.json
Replay 모드 — API 키 없이 결정적 실행
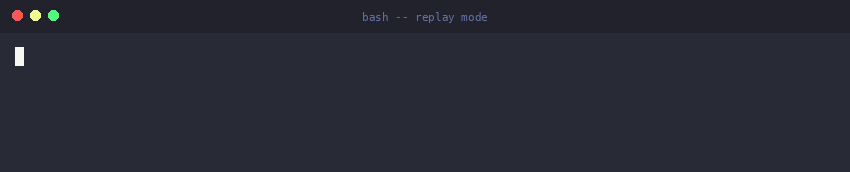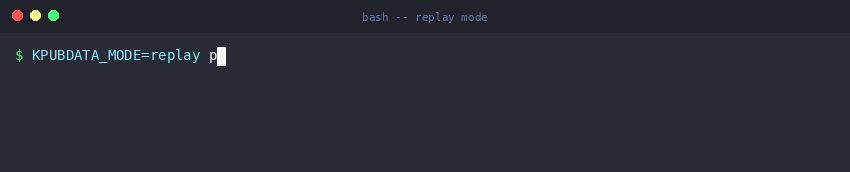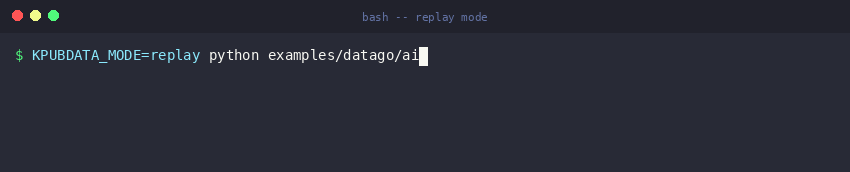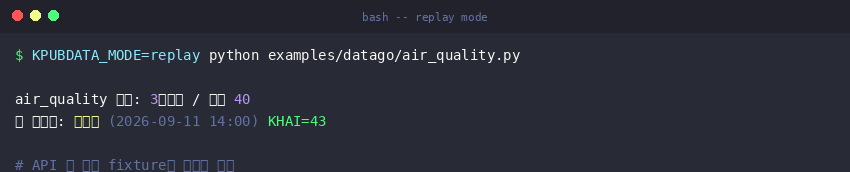
$ # KPUBDATA_MODE=replay 환경변수로 fixture 재생
$ KPUBDATA_MODE=replay python examples/datago/air_quality.py
air_quality 서울: 3측정소 / 전체 40
첫 측정소: 강남구 (2026-09-11 14:00) KHAI=43
spec 검증
$ # spec YAML 스키마 검증
$ uv run python scripts/validate_spec.py
[통과] src/kpubdata/specs/datago/air_quality.yaml
[통과] src/kpubdata/specs/datago/apt_trade.yaml
...
검증 결과: 22개 통과, 0개 실패
LIVE 스키마 diff
$ # 실호출 응답의 필드 구조를 fixture와 비교 (값 변화는 무시)
$ LIVE=1 make verify DATASET=datago.air_quality
[통과] datago.air_quality
  live 스키마 diff: 구조 일치(18필드)
검증 결과: 1개 데이터셋, 전체 통과
상태 페이지 생성
$ # 데이터셋 검증 현황 요약 생성
$ uv run python scripts/gen_status_page.py
생성: docs/status/latest.json, docs/status.md
모든 예시는
kpubdatav0.6.0에서 캡처했다. 출력은 실제 데이터에 따라 달라질 수 있다.